

黑马程序员动态 · 大模型项目解读
黑马程序员发布大模型新项目《黑马直聘》,把招聘职位从自然语言发布、AI抽取结构化标签、标签检索召回串成一条完整链路。这篇动态的重点不只是展示一个招聘搜索案例,更在于说明大模型如何参与真实工程:它不负责闲聊,也不只是生成文案,而是把职位描述读懂成工种、地点、薪资结算、工作时间、福利和要求等字段,帮助搜索从字面匹配走向语义标签匹配。对正在学习AI大模型开发、AI应用与智能体开发的学员来说,这类项目能把模型调用、消息队列、缓存、搜索引擎和可。
原文主题
黑马大模型新项目《黑马直聘》上线
机构
黑马程序员
技术关键词
语义标签、LangGraph、Kafka、Redis、Elasticsearch
学习方向
AI大模型开发、AI应用与智能体开发
招聘搜索为什么容易漏掉好职位
传统职位搜索常依赖标题和描述里的关键词。问题在于,招聘方写的是自然语言,求职者输入的也是自然语言,两边不一定使用同一个词。原文举例里,岗位描述写的是“腌菜厨师、日结上午班”,求职者只搜“厨师”,字面匹配就可能漏掉;如果描述里夹带“滴滴司机”等引流词,又可能把不相关职位推到前面。搜索越忠实于字面,漏召和误召就越难避免。
《黑马直聘》把大模型放在发布阶段
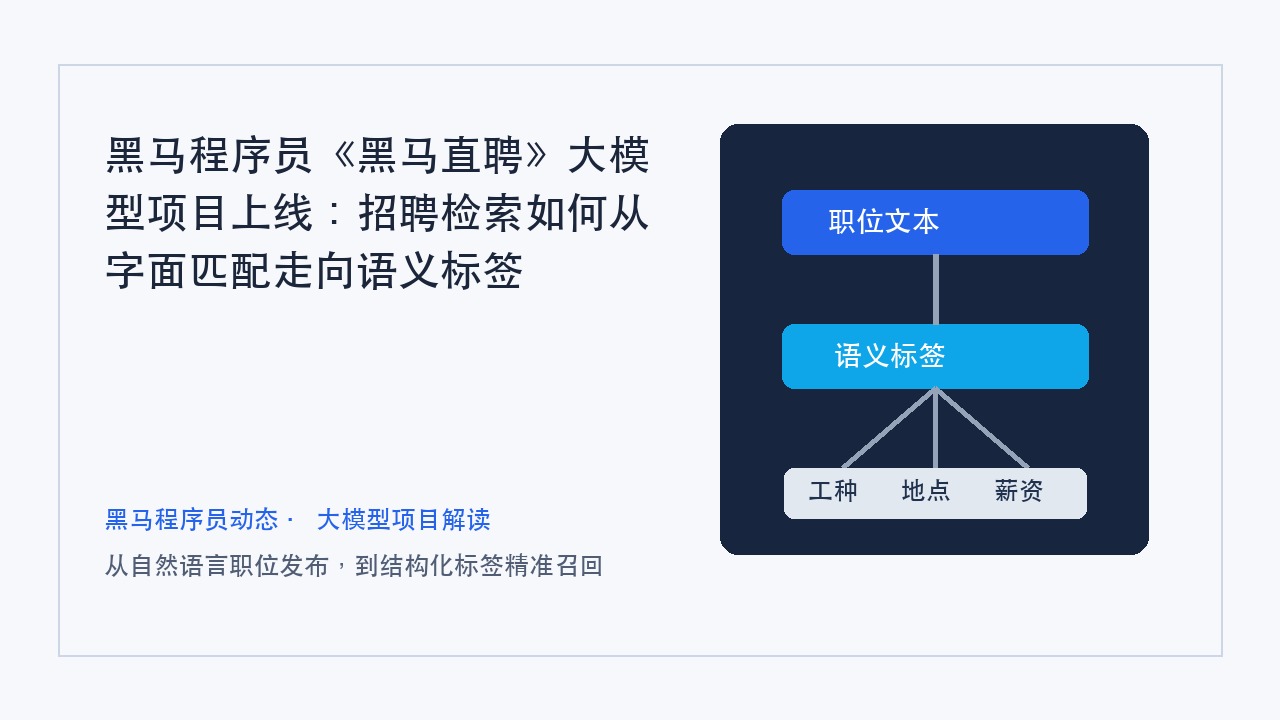
这个项目的关键思路,是不等用户搜索时才让系统猜含义,而是在职位发布时就让大模型先读懂职位。招聘方提交职位后,系统把职位文本送入后台抽取流程,大模型从自然语言中提取工种、地点、用工方式、薪资结算、工作时间、福利和要求等标签,再把这些标签写入搜索引擎与缓存。这样一来,求职者输入“厨师”时,系统可以按工种标签召回,而不是只在原始文本里硬找同一个词。
从字面匹配到语义标签,变化在哪里
全文检索的优势是高效、成熟、可扩展,但它天然更擅长处理“词和词”的命中。大模型加入后,检索链路多了一层语义理解:它先把职位描述转成结构化字段,再让搜索引擎基于字段进行精确召回。搜索引擎仍然负责高性能检索,大模型负责把非结构化文本变成可检索的数据。这种分工,比把所有问题都交给一个聊天模型更适合工程落地。
三段服务解耦,发布不用等待抽取完成
原文提到,项目将发布端、消费端和搜索端拆成相互独立的服务。招聘方点击发布后,发布端把消息写入 Kafka 等消息队列即可返回成功;后台消费端异步调用大模型抽取标签,再写入 Redis 缓存和 Elasticsearch 搜索引擎;搜索端独立处理用户查询。这样的架构能减少发布等待,也方便后续独立扩容、排查和替换某个环节。
LangGraph 工作流让抽取过程更清楚
大模型抽取并不是把所有任务塞进一个超长提示词。项目使用 LangGraph 把流程拆成基础抽取和多路分类:先提取工种、地点、薪资结算、用工、时间、福利等基础实体,再并行完成用工类型、工作场所、薪资结算、工作时间和福利标准化等分类,最后汇聚成一份干净结果。对学员来说,这能直观看到大模型项目不是单次调用,而是可编排、可复用、可观测的工程流程。
搜索端先判断字段,再做精准检索
求职者输入关键词后,系统并不是直接全文搜索,而是先通过缓存判断这个词属于哪个字段。比如“宠物美容师”属于工种,就按工种字段查;如果是地点、薪资或工作时间,也可以进入对应字段。Elasticsearch 结合 IK 中文分词和字段查询,既保留传统搜索引擎的效率,也减少引流词带来的干扰。
可观测链路让问题能被追踪
大模型项目上线后,稳定性和排障能力非常重要。原文提到,项目同时记录应用级 Langfuse Callback 和模型网关 LiteLLM 的调用轨迹,同一次模型调用会留下两条 Trace。通过 request_id,可以把从消息队列消费、模型抽取到写入缓存和搜索引擎的全过程串起来。学习者理解这部分,才能知道企业项目为什么不只看功能跑通,还要看运行过程是否可查。
从云端模型到微调模型,是项目继续变准的路线
项目早期可以调用云端通用大模型,先把端到端链路跑通,验证业务可行性。但招聘领域有自己的表达习惯,通用模型的抽取质量和稳定性可能不够。后续通过 SFT 监督微调、LoRA 低秩适配和 DPO 偏好优化,把模型训练得更懂招聘语言,才能进一步提升标签抽取质量。这个迭代路线,也让学员看到大模型项目从原型到优化的真实过程。
黑马程序员这类项目适合学员关注什么
对准备学习 AI 大模型开发的学员来说,《黑马直聘》的价值在于把很多分散技术放进同一个业务闭环:Python 开发、模型调用、LangGraph、Kafka、Redis、Elasticsearch、IK 分词、Langfuse、LiteLLM、模型微调和工程部署,都围绕一个招聘检索问题展开。理解这种项目,比只看单个工具名更接近企业真实需求。
结论:大模型落地,关键是把能力放进业务链路
《黑马直聘》展示的是一个很典型的方向:大模型不只用来对话,也能成为业务系统中的语义理解层。它把自然语言职位读成结构化标签,让招聘搜索更准、更全,也让后续微调和可观测有了明确目标。对学习者来说,真正值得训练的不是追一个概念,而是把模型、数据、搜索、缓存、消息队列和业务场景连成可交付系统。
常见问题
1. 《黑马直聘》这个项目主要解决什么问题?
它主要解决招聘搜索中的漏召和误召问题:职位描述与求职关键词字面不一致时容易搜不到,描述中夹带引流词时又容易搜偏。项目用大模型抽取语义标签,再按字段精准检索。
2. 这个项目和普通大模型聊天有什么不同?
它不是让模型聊天或写文案,而是把模型放进职位发布后的抽取流程里,把自然语言职位描述转成工种、地点、薪资、时间、福利等结构化字段,再交给搜索引擎使用。
3. 学习 AI 大模型开发为什么要看这类项目?
因为它覆盖了真实工程中常见的完整链路:模型调用、工作流编排、消息队列、缓存、搜索引擎、可观测、微调与业务验证。能理解这类项目,才更容易把 AI 能力落到企业应用里。
温馨提示:AI项目学习要结合个人基础、时间投入和目标岗位判断,具体班型、课程安排和报名信息以最新招生说明为准。


